Почему локальные языковые модели снова становятся интересными
Два года назад запускать модель у себя на железе казалось уделом энтузиастов: облачные API были умнее и дешевле в пересчёте на час работы инженера. В 2025-м пропорция поменялась — и собственный инференс снова стал рациональным инженерным решением, а не жестом протеста.
Два года назад вопросы про локальные модели звучали так: «Зачем возиться с рантаймами и весами, если готовое API стоит копейки?» Сегодня их задают иначе: «Сколько памяти нужно, чтобы держать обработку документов у себя?» — и это уже другой разговор. В этом материале разберём, что изменилось технически, какое железо требуется на самом деле и в каких задачах собственный инференс честно выигрывает у облака.
Первая причина — качественная. Разрыв между открытой моделью на восемь миллиардов параметров и коммерческим API сжался до величины, которую пользователь не замечает. Классифицировать тикет, вытащить поля из счёта, пересказать переписку, ответить на вопрос по документации — компактные модели семейств Qwen, Llama и Gemma делают это стабильно, в том числе на русском. Разрыв остаётся на сложных задачах, но он уже не «небо и земля», а «кандидат и сильный мидл».
Проверяется это не по публичным бенчмаркам, а по собственным задачам. Таблицы лидеров измеряют среднюю температуру по больнице: на агрегатах из английского законодательства модель может отставать на десять пунктов и при этом безошибочно размечать ваши тикеты. Единственная честная методика — прогнать свою выборку; как её организовать, покажем в конце материала.
Вторая причина — инженерная: квантизация перестала быть синонимом деградации. Методы калибровки по важности слоёв позволяют ужать модель в четыре раза с потерей качества, которую в слепом тесте заметят единицы. Третья — экономическая. Агентные сценарии умножают расход токенов: один запрос пользователя порождает десятки обращений к модели, и счёт в облаке растёт быстрее, чем команда успевает оптимизировать промпты.
Возьмём типичный сервис классификации обращений: пятьдесят тысяч обращений в месяц, по пять обращений к модели на каждое. Это четверть миллиона вызовов по триста токенов — около семидесяти пяти миллионов токенов ежемесячно ещё до того, как вы добавите агентные сценарии. На тарифах флагманов счёт идёт на сотни долларов, у локального сервера — на амортизацию и электричество. Арифметика не всегда складывается в пользу своих весов, но посчитать её обязаны все.
К экономике добавляется человеческий фактор. После пары громких историй о том, как данные клиентов оказались в обучающих выборках, юристы начали спрашивать про каждый внешний вызов: куда уходят логи, сколько хранятся, кто их видит. Ответ «нам неизвестно» больше не проходит — а у локального инференса он короткий: никуда, у нас.
Чтобы понимать, что именно изменилось, полезно вспомнить, почему в 2023-м идея казалась тупиковой. Тогда «локальная модель» означала либо семимиллиардную модель, честно терявшую нить после третьего абзаца, либо совсем крошечные сети, годившиеся разве что для автодополнения. Инструменты были сырыми: сборка llama.cpp из исходников, ошибки CUDA на каждом шаге, чат-шаблоны, которые каждый собирал вручную. Добавьте MacBook с восемью гигабайтами памяти — и станет ясно, почему даже энтузиасты возвращались в облако.
Второй сюрприз той волны — экосистема. Форматы и рантаймы менялись каждые полгода, инструкции устаревали быстрее, чем их успевали писать. Сейчас ядро стабилизировалось: GGUF как универсальный формат весов, llama.cpp как движок по умолчанию, Ollama как удобная обёртка над ним. Стабильность — недооценённое условие продакшена: когда инструменты перестают ломаться каждый квартал, их начинают применять всерьёз.
Показательно, как сменилась риторика специалистов. В 2023-м локальный запуск обсуждали как вынужденную меру приватности с потерей качества. В 2025-м те же люди считают стоимость токенов в юнит-экономике продукта и выбирают место исполнения — облако, свой сервер, устройство пользователя — как обычное инженерное решение с понятными компромиссами. Смена тона говорит больше, чем любые цифры.
Сдвиг начался с архитектуры. Плотные модели уступили место смесям экспертов: Qwen3-30B-A3B активирует лишь три миллиарда параметров из тридцати, давая скорость четырёхмиллиардной модели и рассудительность тридцатимиллиардной. Дистиллирование превратилось в индустрию: большие модели явно учат маленьких на своих цепочках рассуждений. И главное — у компактных моделей появились способности, которые раньше были привилегией флагманов: контекст на 128 тысяч токенов, надёжный вызов инструментов, структурированный вывод по JSON-схеме и, у Gemma 3, честное мультимодальное зрение.
Отдельно скажем о русском языке. В 2023-м открытые модели писали по-русски с акцентом кальки, сейчас Qwen и Gemma на бытовых и офисных задачах пишут естественнее, чем часть облачных моделей трёхлетней давности. Узкая терминология всё ещё выдаёт разрыв, но для служебных текстов — тикетов, карточек, писем — его обычно не видно.
Параллельно выросли скорости. Спекулятивное декодирование, при котором маленькая модель-черновик предлагает токены, а большая их подтверждает, ускоряет генерацию в полтора-два раза без потери качества. Кэширование общего префикса промпта экономит секунды на повторных обращениях с одинаковым началом — в агентных сценариях это большинство запросов.
Отдельный пласт изменений — инструменты. Три года назад локальный запуск означал терминал и компиляцию из исходников; теперь у каждого рантайма понятные команды, у LM Studio — интерфейс, в котором разберётся не-инженер, а модель скачивается одной строкой. Появились и метрики самого инференса: токенов в секунду, время первого токена, поведение под параллельными запросами — без них раньше нельзя было даже спланировать железо.
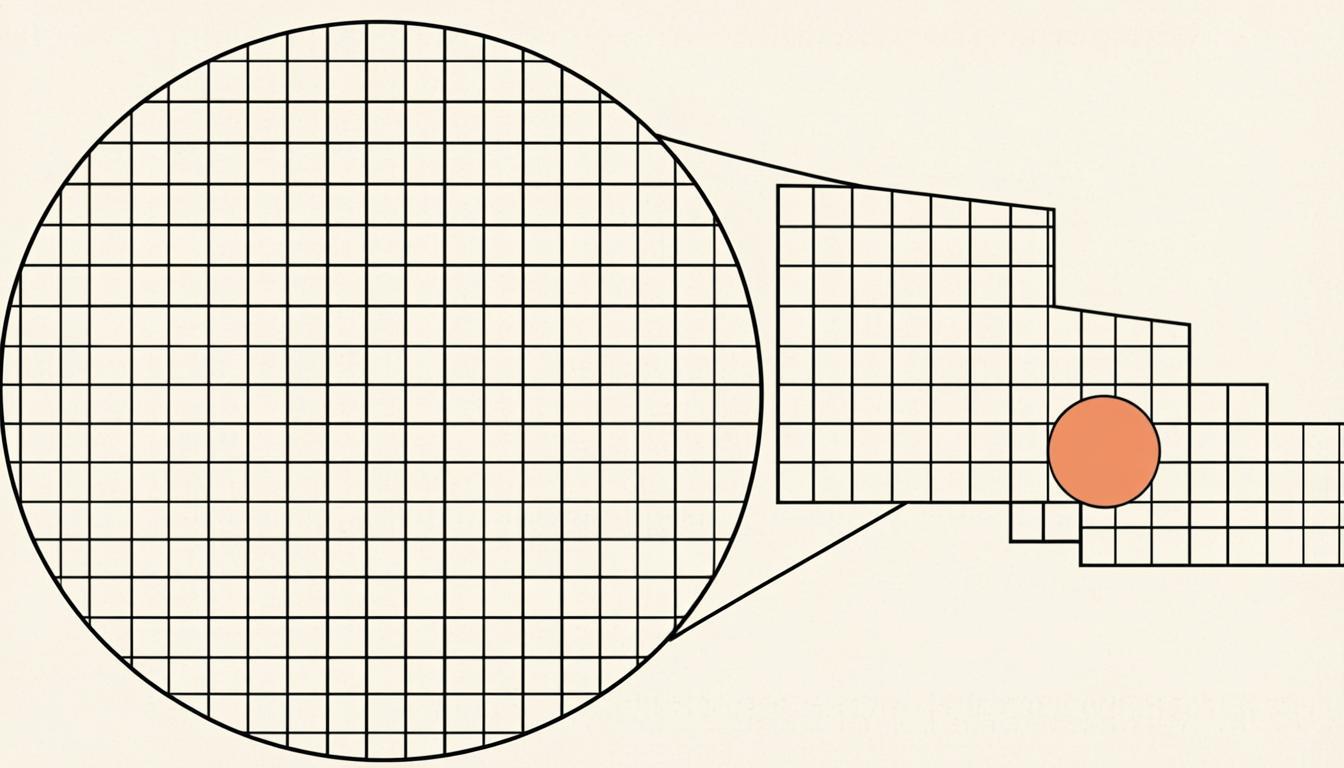
Квантизация снижает точность представления весов: вместо шестнадцати бит на параметр остаётся четыре-восемь. Наивное округление действительно убивало качество. Современные схемы формата GGUF работают иначе: самые чувствительные слои хранятся в повышенной точности, а матрицы весов калибруются по набору реальных данных, чтобы ошибка округления компенсировалась распределением. Схема Q4_K_M — четыре с половиной бита в среднем — стала стандартом де-факто для локального запуска.
Наши замеры на задачах классификации и резюмирования показывают разрыв между Q8 и Q4_K_M в пределах одного-двух процентов — на уровне погрешности разметки. На коде и математике разница заметнее, до десяти процентов, но Q5_K_M обычно закрывает вопрос. Ниже Q3 спускаться стоит только для черновиков: модель начинает терять связность на длинных ответах.
—Q8_0 — почти без потерь, объём вдвое меньше исходника; имеет смысл, когда память позволяет;
—Q6_K — тихий компромисс: качество практически исходное, память меньше в два с половиной раза;
—Q4_K_M — рабочая лошадка локального инференса: минус около трёх процентов качества за четверть исходного объёма;
—Q3 и ниже — только для простых задач и экспериментов: связность страдает, длинные инструкции забываются.
Квантизация «уплотняет» веса модели: четыре бита вместо шестнадцати — цена вопроса три процента качества и три четверти памяти.
Главное заблуждение новичка — гнаться за террафлопсами видеокарты. Генерация токенов упирается не в вычисления, а в пропускную способность памяти: на каждом шаге модель обязана прочитать все свои веса целиком. Поэтому старая видеокарта с широкой шиной часто обгоняет новую с узкой, а быстрая оперативка вывозит модели, целиком в неё поместившиеся. Правило простое: сначала память, потом всё остальное.
С выбором железа стало проще и по другой причине. Бывшие в употреблении серверные ускорители с большой памятью подешевели до уровня флагманских потребительских карт, а новые поколения Apple Silicon с объединённой памятью закрыли сценарий «тихий офисный сервер без отдельной стойки». Для первых экспериментов хватает игровой видеокарты с двенадцатью гигабайтами: этого достаточно для восьмимиллиардной модели в Q4 с рабочим контекстом.
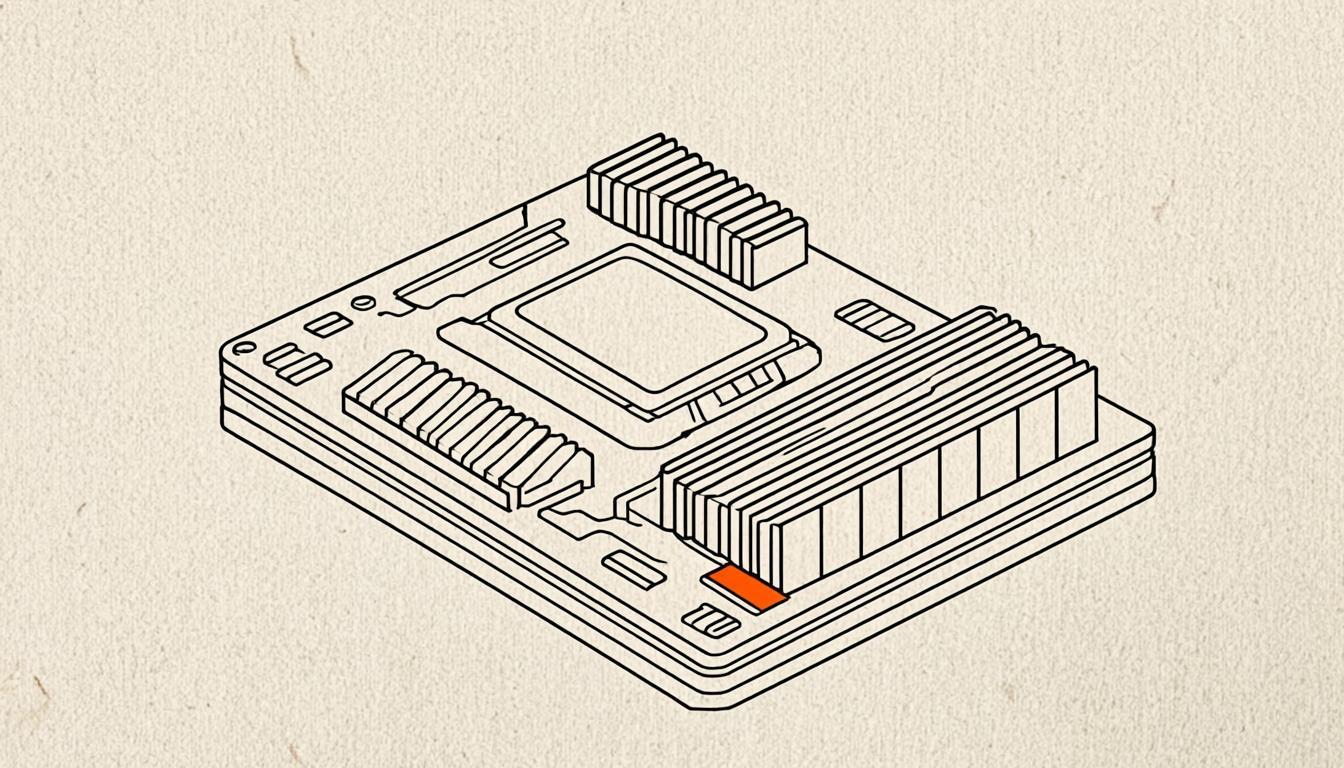
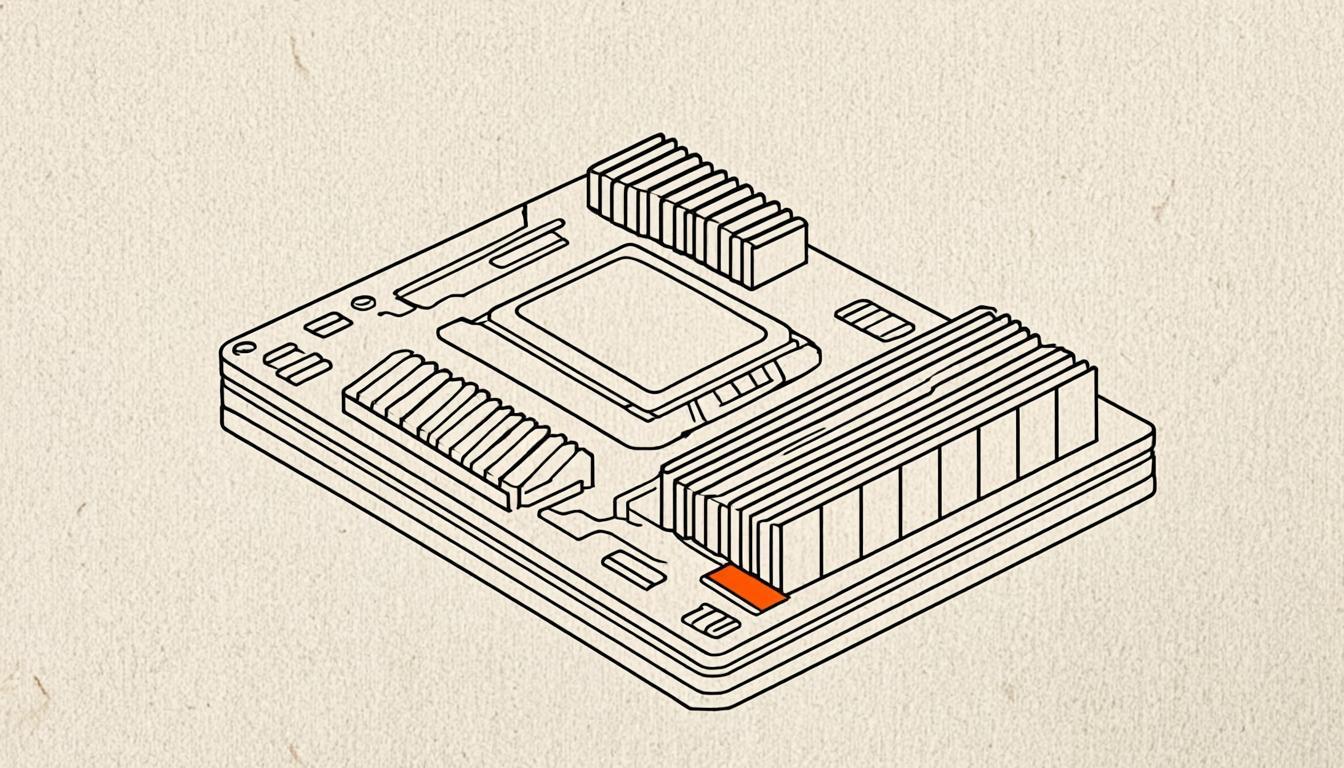
Домашний инференс-сервер: четыре ускорителя, шум и 400 Вт
Память складывается из трёх слагаемых: веса модели, кэш контекста и запас на вычисления. Веса при четырёхбитной квантизации занимают примерно 0,6 гигабайта на миллиард параметров. KV-cache растёт линейно с длиной контекста и числом параллельных сессий — для восьмимиллиардной модели с контекстом в 32 тысячи токенов закладывайте ещё два-четыре гигабайта. Сверху добавьте десять-двадцать процентов на буферы вычислений и словари.
Компактные открытые модели: сравнение
Модель
Параметры
Контекст
Память (Q4)
Qwen3 4B
4 млрд
32K, с YaRN до 128K
≈2,6 ГБ
Llama 3.1 8B
8 млрд
128K
≈4,9 ГБ
Mistral 7B v0.3
7 млрд
32K
≈4,4 ГБ
Gemma 3 12B
12 млрд
128K
≈7,3 ГБ
Цифры зависят от версии квантизации и реальной длины контекста, но порядок именно такой. На машину с 16 гигабайтами видеопамяти помещается восьмимиллиардная модель с большим контекстом; 24 гигабайта хватает двенадцатимиллиардной с запасом на две параллельные сессии. Если вам нужен краткий шорт-лист для старта — берите Qwen3 4B на слабое железо и Llama 3.1 8B на всё, что побогаче.
Стоит помнить и про эксплуатацию. Инференс-сервер — это постоянные 300–400 ватт, слышимые вентиляторы и точка отказа, которую мониторят так же серьёзно, как остальной прод. Обновление весов тоже стало операцией: новая версия модели — это файл на десяток гигабайт, прогон eval-набора и окно для замены. Ничего сложного, но всё это должно появиться в регламенте до, а не после первого инцидента.
llama-server.shShell
#!/usr/bin/env bash# Локальный инференс-сервер на llama.cpp: OpenAI-совместимый API на порту 8080set-euopipefailMODEL="$HOME/models/qwen3-4b-instruct-q4_k_m.gguf"ARGS=(--model"$MODEL"--host127.0.0.1--port8080--ctx-size16384--n-gpu-layers999--flash-attn--parallel2--jinja--mlock)execllama-server"${ARGS[@]}"
Флаг --n-gpu-layers со значением 999 отправляет на видеокарту все слои, какие влезут; --parallel держит несколько сессий одновременно; --jinja включает обработку чат-шаблона прямо на сервере. Дальше с ним можно работать как с обычным OpenAI API — из скрипта, из фреймворка или из любимого редактора.
За полтора года мы перевели на собственный инференс несколько сценариев в разных продуктах и составили карту применимости. Логика у неё простая: чем предсказуемее форма ответа и короче цепочка рассуждений, тем спокойнее можно брать маленькую модель и не платить за облако. В разборе полного цикла агентного запроса мы показывали, какую долю шагов конвейера вообще можно отдать компактной модели.
—Классификация и маршрутизация : тикеты поддержки, тон клиента, приоритет обращения — точность открытых моделей здесь сопоставима с облачными;
—Извлечение структурированных данных : реквизиты из счетов, позиции из договоров, параметры из карточек товаров — при жёсткой JSON-схеме малые модели почти не ошибаются;
—Резюмирование : длинные переписки и протоколы встреч превращаются в пять пунктов со стабильным качеством;
—Эмбеддинги и реранкинг для поиска : собственный векторный индекс дешевле внешнего сервиса — этот путь мы подробно описали в кейсе о переписывании ретривала ;
—Данные, которые нельзя отдавать наружу : медицинские карты, первичная бухгалтерия, переписка под NDA — здесь локальный запуск не оптимизация, а условие существования фичи.
Отдельный пласт — офлайн-сценарии, о которых редко думают заранее. Полевые устройства без связи, борта самолётов, объекты с закрытым контуром: там облако не медленнее — его просто нет. Компактная модель на устройстве превращает «интерфейс подождёт до связи» в «интерфейс работает всегда», и для части продуктов это решающее отличие.
Отдельная история — поисковые сценарии, где модель работает не соло, а в связке с классикой. Локальная модель отлично справляется как реранкер поверх полнотекстового поиска: переупорядочивает пару сотен кандидатов, которые отобрал BM25. Тот же принцип действует и в товарном поиске — материал о поиске по каталогу интернет-магазина описывает архитектуру, поверх которой такой реранкер надстраивается за пару недель.
Честный учёт затрат включает и поддержку. Локальный стек — это своя CI-джоба на обновление весов, свой мониторинг скорости генерации и свой дежурный, который знает, что такое OOM на видеокарте. Мы закладываем на это около пяти процентов времени команды, работающей с инференсом. Для сценариев из списка выше эта цена окупается; для экспериментов «на всякий случай» — нет.
«
Модель на собственном железе возвращает продукту предсказуемость: задержка перестаёт быть лотереей, счёт — сюрпризом, а данные клиента — предметом переговоров с чужими условиями использования.
Честность требует и обратного списка. Компактные локальные модели систематически проигрывают облаку в длинных многошаговых рассуждениях: агентные сценарии с десятью итерациями планирования раскрывают их слабости быстрее любой таблицы бенчмарков. Слабее они и в актуальности знаний: чекпоинт заканчивается датой релиза, а попытка дополнить его свежими данными через длинный контекст работает хуже, чем хочется.
Третья зона риска — тонкая стилистика и редкая терминология. Служебные тексты малые модели пишут чисто, но гибкий юмор, стихи и узкоспециальные глоссарии выдают разрыв с флагманами. Четвёртая — экстремально длинный контекст: заявленные 128 тысяч токенов в реальности работают с провалом посередине, модель надёжно видит начало и конец промпта и заметно хуже — середину. Если задача требует сшить двадцать документов в один ответ, локальная модель пока не лучший выбор.
Практический компромисс, который работает у нас: длинные документы не суются в контекст целиком, а проходят через ретривал. Правильно собранный поиск подаёт модели три-пять релевантных фрагментов вместо сорока страниц — и малая модель показывает качество, которого от неё не ждут на сыром длинном контексте. Гибрид «поиск сверху, модель снизу» закрывает больше задач, чем гонка за параметрами.
Отдельная осторожность — лицензии. «Открытая модель» не всегда значит «свободная для коммерции»: у части весов есть ограничения по числу пользователей, у части — по регионам и по обучению конкурентных моделей. Читайте лицензию до того, как встроите модель в продукт, а не после.
Путь от нуля до рабочего API занимает меньше часа и не требует ничего, кроме машины с 8–16 гигабайтами памяти. Порядок действий, который срабатывает почти всегда.
Железо для пробы — минимальное: подойдёт ноутбук с современным процессором и 16 гигабайтами памяти, на котором четырёхмиллиардная модель генерирует два-три десятка токенов в секунду. Скорость здесь вторична: сначала мы отвечаем на вопрос «справится ли модель с задачей в принципе», и только потом подбираем машину под нужную производительность.
01 Определите задачу и форму ответа: чат, классификация или извлечение полей — от этого зависит выбор размера модели;
02 Скачайте модель в формате GGUF с квантизацией Q4_K_M; берите репозиторий, где указан точный размер файла и есть контрольные суммы;
03 Поставьте рантайм: llama.cpp для контроля, Ollama для простоты, LM Studio для графического интерфейса — все три дают OpenAI-совместимый API;
04 Запустите сервер с ограниченным контекстом: шестнадцати тысяч токенов хватает для большинства тестов;
05 Прогоните свою выборку реальных примеров и сравните с текущим решением по качеству, задержке и стоимости;
06 Зафиксируйте версию модели и квантизации в репозитории: воспроизводимость важнее новости недели.
local_client.pyPython
import httpxAPI_URL="http://127.0.0.1:8080/v1/chat/completions"SYSTEM_PROMPT=("Ты — ассистент поддержки. Отвечай кратко ""и только по фактам из переданного контекста.")defask(question:str, context:str, timeout:float=120.0)->str:"""Один запрос к локальной модели через OpenAI-совместимый API.""" payload ={"model":"local","messages":[{"role":"system","content":SYSTEM_PROMPT},{"role":"user","content":"Вопрос: "+ question +"\n\nКонтекст: "+ context,},],"temperature":0.2,"max_tokens":512,} response = httpx.post(API_URL,json=payload,timeout=timeout) response.raise_for_status()return response.json()["choices"][0]["message"]["content"]
Тот же эндпоинт примут LangChain, LiteLLM и любой инструмент, умеющий ходить в OpenAI API: достаточно поменять базовый URL и добавить ключ-заглушку. Поэтому миграция на локальную модель редко требует переписывания кода — она требует честного сравнения качества на своих данных.
Методика сравнения, которая не врёт: триста реальных вопросов, ответы старого и нового решения в случайном порядке, разметка вслепую двумя людьми. Смотрите не на среднюю оценку, а на долю случаев, где локальная модель хуже, — именно хвост слабых ответов определяет, можно ли выпускать в прод. Средние здесь вредны ровно так же, как в бенчмарках производительности.
Офисный инференс-узел: сборка из четырёх ускорителей и 128 гигабайт памяти.Один и тот же массив весов до и после уплотнения: разница заметна глазом, качество — едва ли.